~数字の裏側にある「誤差」と「偏り」を考える
テレビのニュースや新聞では、「内閣支持率は35%」「この政策に賛成する人は60%」「政党支持率は前回より3ポイント上昇した」といった数字が頻繁に報じられる。政治情勢を判断する材料として世論調査は広く利用されているが、その数字が実際にどの程度正確なのか、疑問を持つ人も少なくないだろう。
日本には1億人を超える人口がいるにもかかわらず、一般的な世論調査で実際に回答するのは千人から数千人程度である。さらに、知らない電話番号には出ない人や、調査への協力を断る人もいる。インターネット調査では、調査会社のモニターに登録した人だけを対象としている場合もあり、回答する人が最初から偏っているのではないかという疑問も生じる。
こうした事情を考えると、「世論調査など信用できない」という結論に傾きたくなるかもしれない。しかし、統計学の観点から見ると、問題はそれほど単純ではない。実際には、千人しか調べていないこと自体が、世論調査の信頼性を損なう最大の原因とは限らないのである。
重要なのは、その千人をどのように選び、誰が回答し、どのような質問を行い、得られた数字をどのように集計したのかということである。世論調査の信頼性を判断するためには、標本調査の数学的な原理と、現実の調査で生じる偏りの両方を理解する必要がある。
全国民を調査しなくても世論を推定できる
世論調査を理解するためには、まず「全員を調べなければ正しい結果は分からない」という考えから離れる必要がある。統計学では、調査したい集団全体を「母集団」、そこから実際に選び出された一部の対象を「標本」と呼ぶ。適切な方法で標本を抽出できれば、母集団の全員を調べなくても、全体の特徴を一定の精度で推定することができる。
例えば、大きな鍋に入ったスープの塩分濃度を調べる場合、鍋の中身をすべて飲んで確認する必要はない。十分にかき混ぜて濃度が均一になった状態で一部を取り出せば、その標本から全体の塩分濃度を推定できる。世論調査も、限られた標本から全体の特徴を推定するという点では、同じ統計学的な原理に基づいている。
ただし、人間の意見はスープのように均一に混ざっているわけではない。年齢、地域、職業、教育歴、所得、政治的関心などによって意見が異なる可能性があるため、調査対象者をどのように選ぶかが重要になる。特定の集団だけが選ばれやすければ、回答者数が多くても母集団全体を適切に代表しているとは限らない。
ここで重要になるのが「無作為抽出」という考え方である。無作為抽出とは、調査者の都合や判断によって対象者を恣意的に選ぶのではなく、あらかじめ定められた確率的な手続きによって標本を選ぶ方法である。ただし、無作為抽出にも複数の方式があり、すべての人が同じ確率で選ばれるとは限らない。抽出確率が異なる場合には、その違いを考慮した集計が必要になる。
つまり、世論調査の信頼性は、調査人数だけでなく、標本が母集団をどの程度適切に代表しているかによって大きく左右されるのである。
千人程度でも統計学的には意味がある
「日本人が1億人以上いるのに、千人程度の調査でよいのか」という疑問は直感的にはもっともである。しかし、標本調査では母集団が十分に大きくなると、必要な標本数は母集団の人数に比例して増えるわけではない。標本誤差の大きさは、主として標本数、回答割合、標本抽出方法によって決まる。
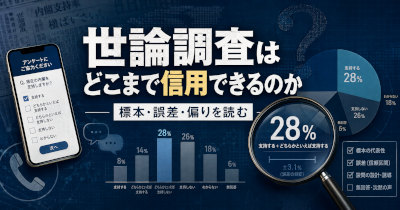
例えば、単純無作為抽出によって1,000人を調査し、ある政策への賛成割合が50%だったとする。この場合、95%信頼水準に対応する標本誤差の幅は、おおむね±3.1ポイントとなる。したがって、標本誤差だけを考えた場合、母集団の賛成割合について、おおむね46.9%から53.1%という信頼区間を計算できる。
ここでいう95%信頼区間とは、同じ条件で標本抽出と区間推定を何度も繰り返した場合、作成された区間の約95%が真の母集団比率を含むという統計的な性質を表している。今回得られた区間の中に真の値が95%の確率で存在すると直接解釈するものではない。また、この計算は標本抽出の確率的な変動を評価したものであり、回答しない人による偏りや質問文の影響まで含んでいるわけではない。
標本誤差の大きさは、標本数の平方根に反比例するという性質を持っている。そのため、回答者数を1,000人から2,000人に増やしても、回答割合50%における誤差幅は約±3.1ポイントから約±2.2ポイントに縮小する程度である。誤差幅を半分にするには、原則として回答者数を4倍にする必要がある。
さらに、回答割合が50%に近い場合には標本誤差が大きくなり、10%や90%のように割合が偏っている場合には、同じ回答者数でも標本誤差は小さくなる。内閣府が公表している世論調査の注意事項でも、標本数と回答割合によって標本誤差が変わることが説明されている。
したがって、適切な抽出方法と集計方法が用いられているなら、千人程度の回答でも全国的な傾向を推定する統計的な意味は十分にある。ただし、標本誤差が±3ポイントだからといって、現実の調査結果全体の誤差も±3ポイント以内に収まると保証されるわけではないことに注意が必要である。
政党支持率31%と29%には明確な差があるのか
標本誤差を理解すると、世論調査の数字の読み方も変わってくる。例えば、ある調査でA党の支持率が31%、B党の支持率が29%だった場合、数字の上ではA党が2ポイント上回っている。しかし、この結果だけで「A党が明確に優勢である」と断定することはできない。
仮に同じ1,000人を無作為抽出し、支持政党を一つだけ選ぶ質問によって両党の支持率を測定したとする。この場合、両党の支持率の差は2ポイントだが、その差について計算される95%信頼区間は、おおむねマイナス2.8ポイントからプラス6.8ポイントとなる。差の信頼区間にゼロが含まれているため、この条件では通常の5%有意水準でA党の支持率がB党より高いとは判定できない。
ここで注意したいのは、同じ調査における二つの政党支持率は、互いに独立した数字ではないという点である。一人が一つの政党しか選べない質問では、A党を選んだ人は同時にB党を選ぶことができない。そのため、二つの支持率を比較する際には、それぞれの標本誤差を単純に足し合わせるのではなく、回答の関係も考慮して差の不確実性を評価する必要がある。
ニュースでは31%と29%という数字が整数で表示されるため、両党には明確な差があるように見えやすい。しかし、観測された数字の大小関係と、母集団において統計的に確認できる差とは同じではない。特に数ポイントの差については、回答者数や標本設計などを踏まえて慎重に判断すべきである。
本当に難しいのは計算できる誤差だけではない
ここまで説明してきた標本誤差は、適切な確率標本の設計を前提とすれば、数学的に推定できる。しかし、現実の世論調査には、それ以外にも複数の誤差が存在する。代表的なものが、調査対象に含まれない人がいることによる「カバレッジ誤差」、回答しない人による「非回答バイアス」、質問文や回答方法などに起因する「測定誤差」である。
これらは、標本抽出の偶然的な変動だけでは説明できない。標本誤差が小さくても、特定の集団が調査対象から漏れていたり、回答者が特定の考え方に偏っていたりすれば、母集団の実態から系統的にずれた数字が得られる可能性がある。
例えば、無作為に3,000人を選び、そのうち1,500人が回答したとする。回答者の政策賛成率が60%だったとしても、回答しなかった1,500人の賛成率が40%であれば、抽出された3,000人全体の賛成率は50%になる。回答者だけを集計した60%という数字は、全体の50%から10ポイントもずれていることになる。
もちろん、この数字は非回答バイアスの仕組みを説明するための仮定であり、実際の非回答者の意見を簡単に確認できるわけではない。むしろ、回答しなかった人の意見が分からないことこそが、非回答バイアスを評価する難しさなのである。
政治への関心が高い人ほど調査に協力しやすい場合や、特定の政策に強い意見を持つ人ほど回答しやすい場合には、最初の標本抽出が適切でも最終的な回答者に偏りが生じ得る。ただし、政治的関心や支持政党が常に回答率を大きく左右するとは限らず、どの属性や意識が回答行動と関係するかは、実際の調査によって異なる。
つまり、最初に無作為抽出したことと、最終的に回答した人々が母集団を適切に代表していることは、同じではないのである。
回答率が低い調査は信用できないのか
では、回答率が低い調査は、それだけで信用できないのだろうか。これについても、単純な結論は出せない。回答率が低くても、回答者と非回答者の間に測定したい意見について大きな違いがなければ、推定結果の偏りは小さくなる可能性がある。逆に、回答率が比較的高くても、特定の集団だけが回答しにくければ、無視できない偏りが生じることもある。
米国のPew Research Center(ピュー・リサーチ・センター・世論調査や社会動向を研究する米国の非営利調査機関)は、2017年に低回答率の電話調査について分析を公表している。この研究では、回答率が約9%という状況でも、2016年の調査結果を外部の基準値と比較した13項目の平均絶対差は2.7ポイントだった。一方、市民活動や地域活動への参加などについては、調査結果が外部の基準値を大幅に上回る例も確認されている。
この研究から分かるのは、回答率が低いことだけを理由に調査結果を無意味と判断できない一方、すべての質問について同じ程度の精度が保証されるわけでもないということである。調査方法の精度は、何を測定するかによっても異なる。また、この研究で検証された項目には外部の比較基準が存在していたが、内閣支持率や政策への賛否のように、調査時点の正解値を直接確認できない項目では、同じ方法で偏りを評価することは難しい。
したがって、回答率は調査の品質を判断する重要な情報ではあるものの、回答率だけで調査の信頼性を決めることはできない。母集団の構成、対象者の抽出方法、非回答者の特徴、調査結果の補正方法などを総合的に確認する必要がある。
人口構成を補正すれば偏りは解消するのか
現実の世論調査では、回答者の年齢、性別、地域などの構成が母集団と一致しない場合がある。このような場合、人口統計などの外部情報を利用し、回答者ごとに異なる重みを付けて集計する「重み付け」という方法が用いられることがある。
例えば、若年層の回答割合が実際の人口構成より少なければ、その回答に大きな重みを与えて集計することで、人口構成の違いを補正できる場合がある。ただし、年齢や性別の構成を一致させても、それらの属性が同じ人々の間で政治的関心や政策への態度が異なっていれば、偏りが残る可能性がある。重み付けは有効な統計手法であるが、すべての偏りを自動的に解消する方法ではない。
さらに、重み付けには別の注意点もある。特定の回答者に大きな重みを与えると、一部の回答が集計結果に強く反映されるため、推定値のばらつきが大きくなる場合がある。この影響はデザイン効果(Design Effect・標本設計や重み付けなどによって推定値の分散がどの程度変化するかを示す指標)によって評価できる。
仮に回答者が1,000人で、デザイン効果が1.5だった場合、標本誤差の観点から見た有効標本数は約667人相当になる。回答割合50%の95%信頼水準に対応する誤差幅も、単純無作為抽出1,000人の場合の約±3.1ポイントから、約±3.8ポイントへ拡大する。この1.5という数値は説明のための仮定であり、日本の世論調査で一般的に確認されている値を意味するものではない。
このように、実際に回答した人数と、統計的な精度を表す有効標本数は必ずしも一致しない。したがって、調査結果に示された回答者数だけで精度を判断するのではなく、可能であれば標本設計や重み付けの方法も確認することが望ましい。
固定電話だけで世論を測ることは難しくなっている
電話による世論調査も、社会の変化に合わせて方法が変わってきた。かつては固定電話を利用した調査が中心だったが、携帯電話の普及によって固定電話を持たない世帯が増えると、固定電話だけを対象とする調査では、特定の人々が調査対象から漏れる問題が大きくなった。
そこで利用されるようになったのが、固定電話と携帯電話の双方を対象とするRDD(Random Digit Dialing・無作為に電話番号を生成して発信する調査方式)などの方法である。日本でも報道機関や調査機関によって固定電話と携帯電話を組み合わせた方式が導入され、対象者の選定や集計方法の改善が進められてきた。
しかし、携帯電話を調査対象に加えれば、すべての問題が解消するわけではない。知らない番号からの着信には応答しない人、仕事や育児などの事情で電話に出られない人、調査だと分かった時点で回答を断る人もいる。そのため、電話番号を無作為に選んだとしても、実際に電話に出て調査へ協力した人々には偏りが生じる可能性がある。
また、電話番号を無作為に選ぶことと、個人を等しい確率で選ぶことも同じではない。複数の電話番号を利用する人や、固定電話のある世帯で誰が回答するかという問題があり、調査の設計によっては抽出確率の違いを補正する必要がある。
なお、日本の世論調査がすべて電話方式で行われているわけではない。内閣府の調査では、住民基本台帳などを利用した抽出に基づく郵送方式も採用されており、面接、郵送、電話、インターネットなど、それぞれの調査方法には異なる特徴がある。
インターネット調査は電話調査より信用できないのか
電話調査に問題があるなら、インターネット調査に切り替えればよいのではないかという考え方もある。しかし、インターネット調査にも独自の問題があり、特に調査対象者の選定方法によって統計的な性質が大きく異なる。
重要なのは、インターネット調査を一括りにしないことである。住民基本台帳などから無作為に対象者を選び、回答手段としてインターネットを利用する確率標本型の調査と、あらかじめ登録されたモニターから回答者を募集する非確率型の調査とでは、標本の代表性に関する前提が異なる。
登録モニター型の調査では、調査会社へ登録している人と登録していない人との間に、年齢、生活状況、政治的関心、回答への積極性などの違いが存在する可能性がある。また、回答者の募集方法や回答回数などによっても、特定の人々が回答しやすくなることがある。この場合、回答者数を増やしても、登録者とそれ以外の人々の違いが自動的に解消されるわけではない。
Pew Research Centerが2023年に公表した研究では、米国のオンライン調査について、確率標本型と登録モニターなどを利用した非確率型の標本を比較している。外部の基準値が利用できる28項目で評価したところ、確率標本型の平均絶対誤差は2.6ポイント、非確率型では5.8ポイントだった。非確率型の誤差は平均すると約2.2倍だったことになる。
ただし、これは米国の特定の調査標本と評価項目を比較した結果であり、日本のインターネット調査が常に同じ程度の誤差を持つことを意味するものではない。また、外部の基準値との違いを測定した結果であり、内閣支持率や政策への賛否について同じ誤差幅が生じると断定することもできない。
日本でも、インターネット調査と国勢調査、面接調査などを比較し、回答者の属性や回答傾向に違いが生じることが研究されている。さらに内閣府は、2026年3月に公表した調査研究で、郵送調査、インターネット調査、電話調査を同時期に実施し、調査方法による回答傾向や回答者属性の違いを比較している。こうした研究は、調査方法による差を実際のデータから検証しようとするものである。
近年のインターネット調査では、さらに不誠実な回答や機械的な回答への対策も重要になっている。2026年8月にPew Research Centerが公表した研究では、不適切な回答者を検出する複数の方法を比較し、回答の品質を改善できる場合がある一方、選別方法によっては正当な回答者まで除外され、別の偏りを生む可能性があることも示されている。
つまり、電話調査だから正しく、インターネット調査だから間違っているという判断は適切ではない。どのように対象者を選び、回答の品質を確保し、集計上の偏りを補正しているかが重要なのである。
質問文を変えるだけでも結果は変わる
世論調査には、標本の選び方とは別に、質問方法による問題も存在する。人間の意見は、必ずしも最初から明確な数値として存在しているわけではなく、質問された内容や、そのときに与えられた情報によって判断が変化する可能性がある。
例えば、ある政策について「この政策に賛成ですか」と尋ねる場合と、「この政策には年間一定額の財政負担が必要ですが、それでも賛成ですか」と尋ねる場合とでは、回答割合が異なる可能性がある。ただし、後者は単に表現を変えたのではなく、財政負担という新たな判断材料を提示しているため、両者が完全に同じ意見を測定しているとも限らない。
また、「賛成」「反対」の二択と、「賛成」「どちらかといえば賛成」「どちらかといえば反対」「反対」の四択では、回答者が自分の意見を表現する方法が異なる。「分からない」「どちらともいえない」という選択肢の有無や、回答を求める順序によっても結果が変化する場合がある。
質問の順番も無視できない。景気への不安を尋ねた直後に政府の政策を評価してもらう場合と、最初に政府への評価を尋ねる場合では、回答者が判断するときに思い浮かべる情報が異なる可能性がある。面接調査や電話調査では、調査員の説明方法や回答者の受け止め方が影響することも考えられる。
したがって、世論調査とは、人々の心の中に存在する固定的な「本当の数字」をそのまま取り出す行為ではない。特定の時点に、特定の質問と回答方法を提示したとき、人々がどのように答えるかを測定する行為である。
これは世論調査が無意味であることを示しているのではなく、測定結果を解釈する際には、質問内容と測定条件を考慮しなければならないことを意味している。
1回の数字だけでなく、継続的な変化を見る
世論調査を読む際には、一度の結果を絶対視しないことも重要である。例えば、ある調査機関が同じ方法で実施した内閣支持率が、40%、38%、35%、32%と推移していれば、継続的に支持が低下している可能性を考えることができる。
仮に各回の回答者数が1,000人で、それぞれ独立に単純無作為抽出されたとする。この条件で支持率が40%から32%へ低下した場合、8ポイントという差の95%信頼水準に対応する誤差幅は約±4.2ポイントとなる。標本誤差だけを考えれば、支持率が低下したと判断できる差である。
一方、40%から39%へ1ポイント低下した場合には、同じ条件で計算される変化量の誤差幅は約±4.3ポイントとなる。この場合、観測された1ポイントの差だけから、実際に支持が低下したとは判断できない。
ただし、時系列で数字を比較する際には、調査方法が継続していることも重要である。電話調査からインターネット調査へ方式を変更したり、質問文や選択肢を変えたり、集計の重み付け方法を変更したりした場合には、社会全体の意見が変わっていなくても、調査結果に差が生じる可能性がある。
また、毎回同じ人を調査する場合と、毎回異なる人を調査する場合では、変化量の統計的な性質も異なる。したがって、単純に前回との差を計算するだけでは、変化の信頼性を十分に評価できないこともある。
重要なのは、単なる数字の連続ではなく、比較できる条件で観測された変化かどうかを確認することである。調査方法が安定しており、同じ方向の変化が複数回確認できる場合には、一回だけの数字よりも有用な情報が得られる。
複数の調査機関の結果を比較する意味
世論調査を評価する際には、一つの調査機関の結果だけでなく、複数の調査機関の結果を比較することも有効である。調査機関によって標本抽出方法、質問文、調査時期、回答方法、集計方法などが異なるため、内閣支持率などの水準に一定の差が生じることは珍しくない。
例えば、ある調査機関の内閣支持率が40%、別の機関では35%だったとしても、その違いだけでどちらかが誤っているとは判断できない。調査時期の違いや質問方法などによって結果が変化する可能性があり、各機関が必ずしも完全に同じ対象を測定しているとは限らないからである。
一方、複数の調査機関が継続的にほぼ同じ方向の変化を示している場合には、実際に社会の意識が変化している可能性を考える材料になる。特に異なる標本抽出方法や調査方式を採用する機関が同様の変化を観測していれば、一つの調査方法だけに由来する現象ではない可能性が高まる。
ただし、複数の調査機関が一致したからといって、必ず正しいとは限らない。調査機関が共通する人口統計を使って補正していたり、同じような非回答構造を持っていたりすれば、共通の偏りが残る可能性がある。複数の数字を平均すれば、偶然的なばらつきを縮小できる場合はあるが、共通する系統的な偏りまで自動的に消えるわけではない。
したがって、複数の調査結果を比較する際には、単純な平均値だけでなく、調査機関ごとの継続的な傾向や調査方法の違いにも注意する必要がある。
世論調査と選挙予測は同じものではない
世論調査が批判されやすい場面の一つが、選挙結果との比較である。選挙前に公表された支持率や情勢調査と、実際の選挙結果が異なった場合、「世論調査は外れた」と評価されることがある。
しかし、調査時点で誰を支持しているかという質問と、投票日に誰が当選するかという予測は、測定している対象が異なる。調査から投票日までの間に支持を変更する人もいれば、投票へ行くつもりだったのに実際には行かなかった人もいる。また、調査時点では投票先を決めていなかった人が、投票日までに判断することもある。
さらに、選挙結果を推定するためには、候補者への支持だけでなく、どのような人が実際に投票するのかを考慮しなければならない。年齢、地域、政治的関心、過去の投票行動などを使って投票者を推定する方法もあるが、その推定自体にも不確実性が存在する。
したがって、調査時点における有権者の意識を測定する世論調査と、将来の選挙結果を予測するモデルは区別して考える必要がある。ただし、選挙予測には結果との事後比較が可能という特徴もあり、予測がどの程度正確だったのか、どのような偏りがあったのかを検証することは重要である。
世論調査が選挙結果と異なった理由を、すべて投票日までの意見の変化に求めるのも適切ではない。標本抽出、非回答、投票者の推定、調査時点から投票日までの変化など、複数の要因を検討する必要がある。
「世論調査は操作されている」と考える前に
世論調査の数字が自分の感覚と大きく異なると、「こんな結果になるはずがない」「調査機関が数字を操作しているのではないか」と疑いたくなることがある。しかし、自分の周囲の人々も、全国民から無作為に選ばれた集団ではないことに注意する必要がある。
家族、友人、職場、地域社会などで日常的に接する人々は、年齢、職業、所得、生活環境、価値観などが自分と近い場合がある。また、SNS(Social Networking Service・インターネット上で情報共有や交流を行うサービス)では、自分の興味や過去の閲覧行動に応じて情報が表示されることがあり、似た意見を持つ人々が実際以上に多いように感じる可能性がある。
そのため、「私の周囲では誰もその政策に賛成していない」という経験と、「全国調査では40%が賛成している」という結果が同時に成立することは十分にあり得る。私たちが日常生活で接している人々も、ある意味では偏りを持った標本なのである。
一方、世論調査に意図的な操作の余地がまったく存在しないと断定することもできない。質問文や対象者の選定方法、集計の取り扱いなどによって、結果に影響を与えることは理論的には可能である。しかし、異なる調査結果が存在することや、自分の感覚と数字が一致しないことだけでは、意図的な操作の証拠にはならない。
重要なのは、疑惑を感覚だけで判断せず、調査方法や集計条件を確認することである。質問文の公開状況、標本の選定方法、回答者数、回答率、補正方法などが明らかにされていれば、その結果を第三者が検証しやすくなる。逆に、調査方法に関する情報が十分に開示されていなければ、結果の信頼性を評価すること自体が難しくなる。
世論調査の信頼性を左右する情報公開
世論調査の信頼性は、統計手法だけではなく、調査に関する情報がどの程度公開されているかにも関係する。どれほど高度な集計方法を使っていても、対象者の選定方法や質問文が分からなければ、第三者がその数字の意味を適切に評価することは難しい。
米国のAAPOR(American Association for Public Opinion Research・米国世論調査研究協会)は、世論調査の透明性を重視し、調査主体、資金提供者、調査対象、標本抽出方法、質問文、調査時期、回答者数、重み付け方法などの情報公開を求めている。これは専門職団体の調査基準であり、日本のすべての世論調査機関に直接適用される法律ではないが、調査の品質を評価する際の重要な考え方となっている。
日本でも内閣府は、世論調査の対象者数、有効回収数、標本抽出方法、調査方法などを公表している。ただし、報道機関や民間調査会社の世論調査について、すべてが同一の方法で実施され、同じ情報公開基準に従っているわけではない。
世論調査の数字が社会的に大きな影響を持つことを考えれば、調査結果の数値だけでなく、その数値がどのように得られたのかを確認できることが重要である。特に政治的に注目度の高い調査ほど、調査方法の透明性が求められる。
世論調査を見るときに確認したい8つのポイント
では、私たちは世論調査の結果をどのように読めばよいのだろうか。基本となるのは、数字だけに注目するのではなく、その数字がどのような条件で得られたのかを確認することである。
第一に、調査対象となる母集団を確認する必要がある。全国の成人なのか、有権者なのか、特定の地域の住民なのかによって、結果が意味する範囲は異なる。第二に、調査時期を確認する。政治情勢は短期間で変化する可能性があるため、いつ実施した調査なのかは重要である。
第三に、標本抽出方法を確認する。無作為抽出なのか、登録モニターによる調査なのかによって、統計的な推定に必要な前提が変わる。第四に、回答者数を見る。一般に回答者数が少ないほど標本誤差は大きくなるが、単純な人数だけでは推定精度を判断できない。
第五に、回答率を確認する。回答率が低いからといって必ず不正確とは限らないが、回答者と非回答者の間に違いが存在する可能性を考える必要がある。第六に、集計や補正の方法を確認する。年齢、性別、地域などによる重み付けを行っている場合には、その方法や調査設計による精度への影響も重要になる。
第七に、質問文と選択肢を確認する。同じ政策に関する調査でも、質問の表現、回答方法、質問順序が異なれば、単純に数字を比較できない場合がある。第八に、過去の調査や他の調査機関との比較可能性を確認する。調査方法が継続しているか、質問内容に変更がないか、他社との違いがどの程度存在するかを検討する必要がある。
これらに加えて、誰が調査を実施し、誰が費用を負担したのかという情報も、透明性を評価する材料となる。すべての世論調査で詳細な情報を確認できるとは限らないが、少なくとも調査方法が十分に公開されていない結果については、数字を過度に信頼しない姿勢が必要だろう。
世論調査の信頼性は一つの数字では表せない
ここまで考えると、世論調査の信頼性を単一の指標だけで判断することが難しいことが分かる。回答者数が多ければ必ず正確になるわけではなく、回答率が高ければ偏りがないとも限らない。無作為抽出を採用していても非回答の問題は残り、人口構成を補正しても、測定したい意見の偏りまで完全に修正できるとは限らない。
さらに、調査方法の違いは質問内容によって異なる影響を与える可能性がある。年齢や世帯構成などの比較的明確な属性については外部の統計と照合できる場合があるが、内閣支持率や政策への賛否のような意識については、直接比較できる客観的な正解値が存在しないことも多い。
そのため、世論調査の品質を評価するときには、標本抽出による誤差、非回答による偏り、調査対象から漏れる人々、質問方法による測定誤差、集計方法による影響などを総合的に考える必要がある。これらをまとめて評価しようとする考え方は、現代の社会調査方法論でも重視されている。
また、世論調査は社会の意見を単に観測するだけでなく、調査結果が報道されることで人々の認識に影響を与える可能性もある。ただし、その影響がどの程度生じるかは、報道内容や社会情勢、受け手の態度などによって異なり、世論調査の公表が常に特定の方向へ人々を誘導すると考えることはできない。
したがって、世論調査の数字を読む側には、統計的な不確実性を理解するだけでなく、その数字が何を測定しており、何を測定していないのかを見極める姿勢が求められる。
世論調査は「真実」ではないが「無意味」でもない
結局、世論調査はどこまで信用できるのだろうか。最も適切な答えは、一定の誤差と偏りが存在することを理解し、その調査の設計や品質に応じて利用するなら、社会全体の意識や変化を知るための有力な手段であるということになる。
世論調査は国民全員の意見を直接数えた結果ではなく、限られた標本から母集団の特徴を推定したものである。そこには標本誤差が存在し、回答しない人による偏りや質問方法による違いも加わる。したがって、内閣支持率35%という数字を、国民の正確に35%が支持しているという絶対的な事実として受け取るべきではない。
しかし、適切な標本設計と集計方法を用いた世論調査であれば、全国的な傾向について有用な情報を得ることができる。実際、回答率が低下した現代の調査でも、外部の基準値と比較して比較的小さな差に収まる項目があることが研究によって確認されている。一方、調査方法や測定内容によっては大きな偏りが生じることもあり、すべての数字を同じ程度に信用できるわけではない。
世論調査の結果が自分の予想と異なるからといって、直ちに間違いだと判断することは適切ではない。同時に、調査機関が公表した数字だからという理由だけで、無条件に信用することも適切ではない。必要なのは、どのような方法で測定され、どの程度の不確実性が存在するのかを確認し、その限界を理解したうえで利用することである。
特に数ポイントの支持率の差や前回調査からの変化を評価するときには、統計的な誤差を考慮することが重要である。また、一回の結果だけで判断せず、同じ条件で実施された継続的な調査や、異なる調査機関の結果を比較することにも意味がある。ただし、時系列や複数機関の比較によっても、共通する偏りが完全に取り除かれるわけではない。
世論調査は社会を映す完全な鏡ではない。標本抽出の方法、回答する人々の特徴、質問の仕方、集計の方法によって、その鏡にはさまざまなゆがみが生じ得る。しかし、多少のゆがみが存在するからといって鏡そのものを捨ててしまえば、社会全体の意識を数量的に把握するための重要な手段を失うことになる。
大切なのは、鏡にゆがみが存在することを認め、そのゆがみがどのような条件で、どの程度生じ得るのかを科学的に検証することである。世論調査を無条件に信じるのでも、全面的に否定するのでもなく、統計学と調査方法論に基づいて慎重に読み解く。その姿勢こそが、数字の向こう側にある社会の変化を、より客観的に理解するために必要なのである。